AI 不只是工具,是记得住你的产品伙伴
Day 1 晚上|AI 不只是工具,是记得住你的产品伙伴
学习目标: 看元峰怎么把一个真实痛点做成一款产品——AI 不只是能写代码,也能是能持续协作的产品工程伙伴;然后打通 Obsidian——搞懂为什么它能当你的"外挂大脑",以及 Obsidian 里的 Codex 和你一直在用的是不是同一个东西。
元峰把一个痛点,做成了一款产品
这两天你一直在用 Codex——桌面端、可能还有 CLI、Obsidian 插件。如果你同时用了不止一个入口,有没有遇到过这种情况:昨天跟 AI 聊出来的一段重要内容,今天想接着往下做,却找不到那段对话在哪了。
这正是元峰自己真实遇到的痛点,而他没有将就着忍,是直接把这个痛点做成了一款产品。
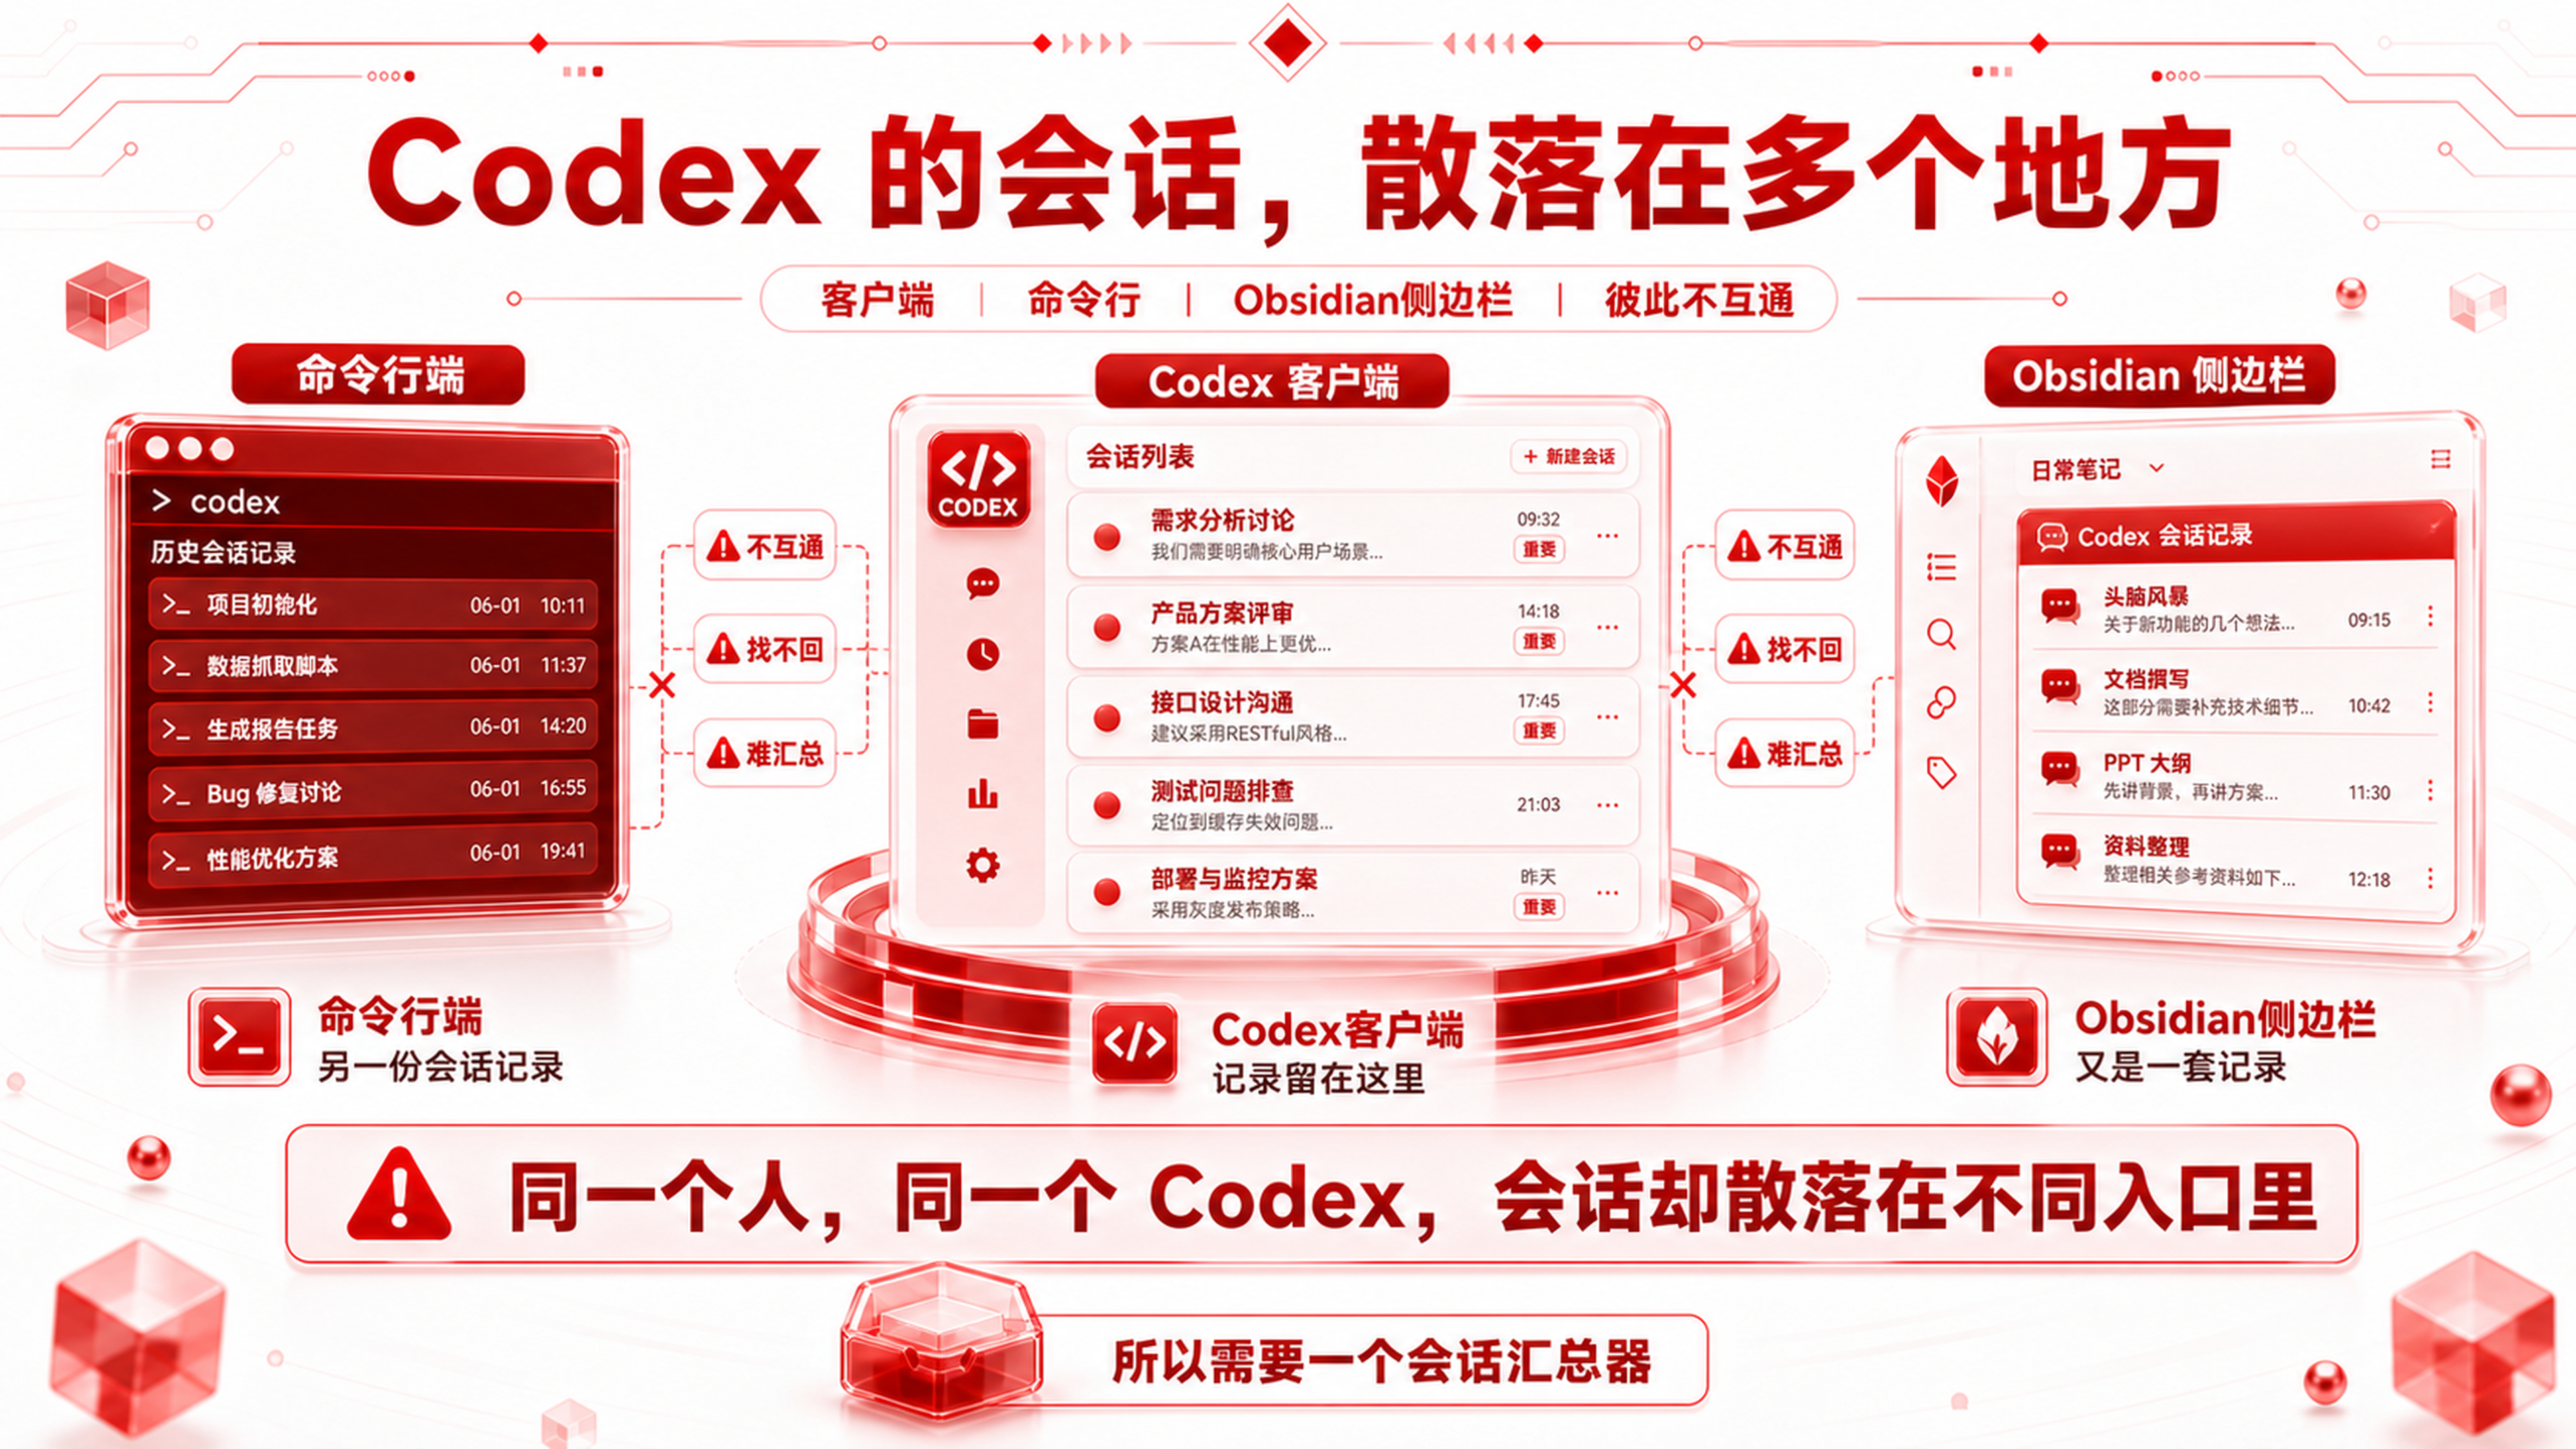
痛点:会话记录,散得到处都是
元峰同时会用 Codex 桌面版、Codex CLI、终端里的 codex exec,还有 Obsidian 插件、飞书 / Coze 的 Bridge 环境——不同入口都会产生自己的会话记录,但彼此不互通。
- 用 ChatGPT 账号登录桌面端时,看不到用 API 时留下的记录
- 在 CLI 里跑出来的会话,桌面客户端里翻不到
- 有的会话很重要(完整做出了一个产品),有的只是测了一句"你好"——但界面上一视同仁,分不出轻重
- 底层数据分散在 SQLite、JSONL、日志、归档目录里,普通人根本没法直接读
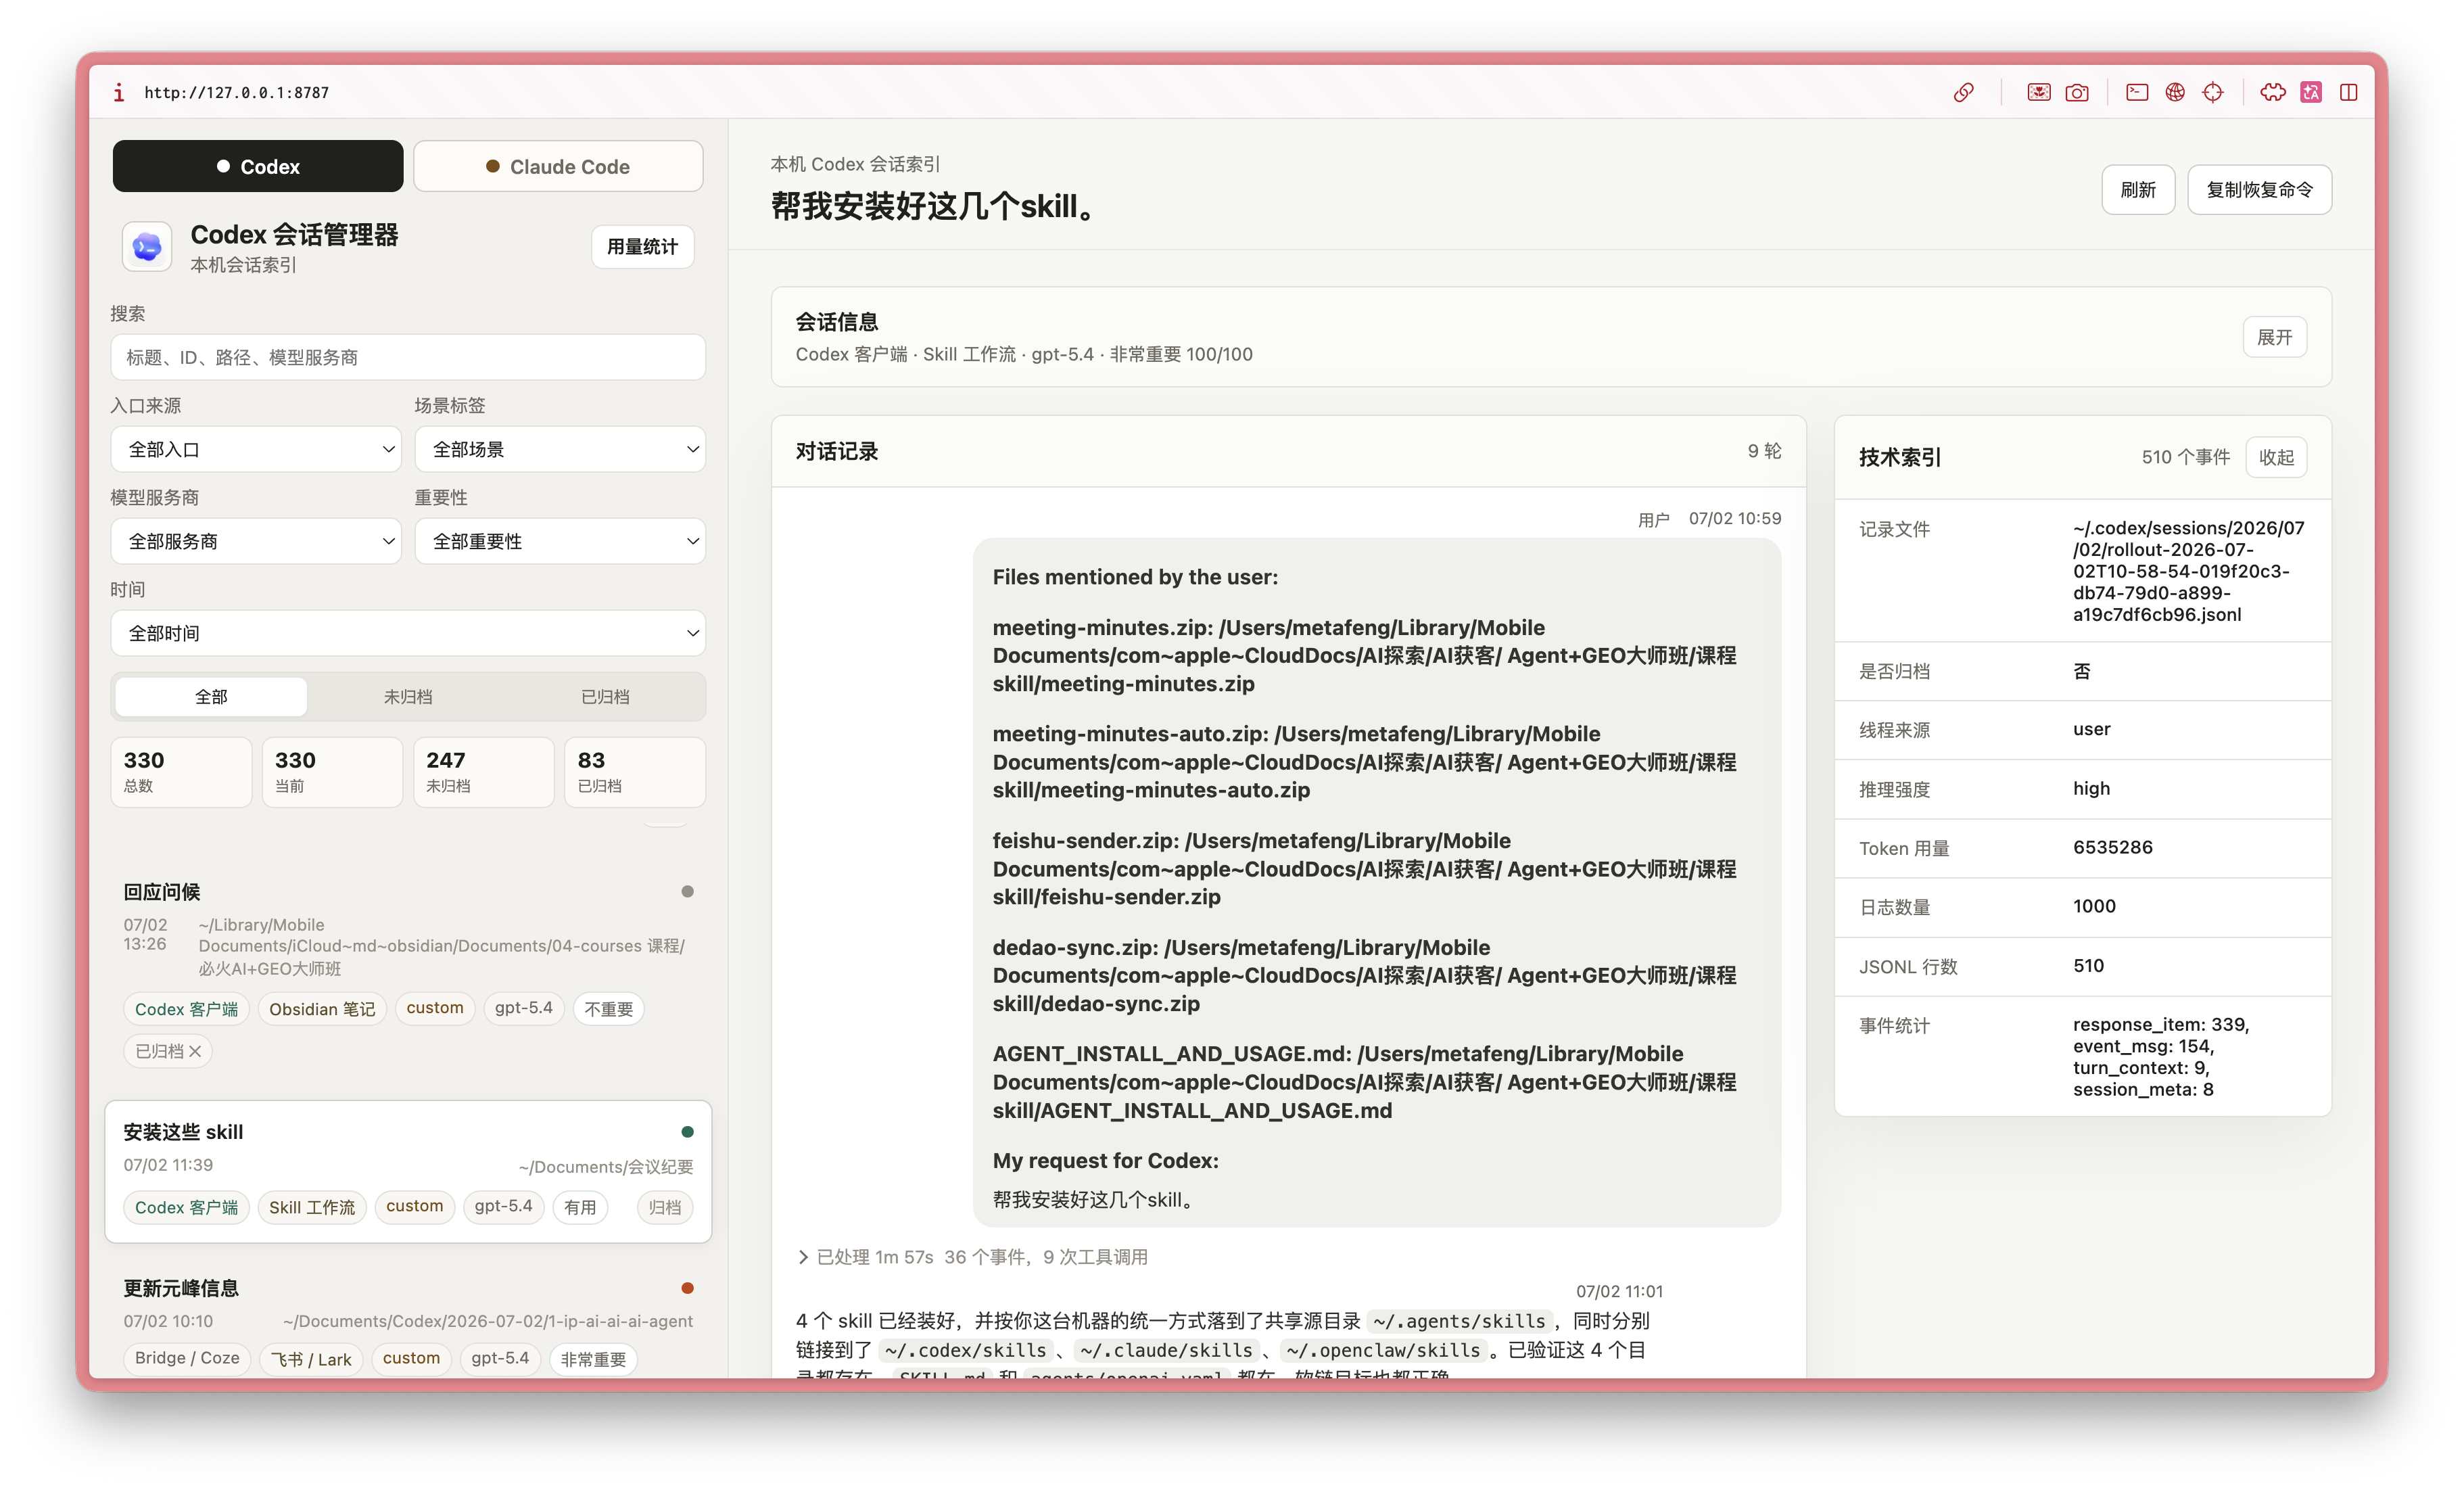
目标很明确:做一个可视化的会话管理器,能看清每段会话来自哪里、能不能一键恢复、能像 Codex 桌面端一样把当时的对话过程重新看一遍。
怎么跟 AI 沟通的:不是一次性甩需求,而是一步步收敛
第一步,先问机制,不急着让 AI 写代码
"Codex 的 session 之间的管理机制是怎样的?"
先把底层逻辑搞懂——数据存在哪、ID 怎么查、恢复命令是什么——而不是一上来就要一个好看的界面。
第二步,才明确产品形态
"帮我做一个可视化的 session 管理器,界面跟 Codex 桌面版类似,清晰、明了、简洁。"
一句话给了三个边界:产品类型、审美方向、体验要求——比只说"做得好看点"好落地得多。
第三步,靠截图持续校准,不空谈"还不够好"
"来源下拉菜单出现乱码" "Conversation 区域反复出现'codex'这种技术词,不像桌面端" "热力图缺少月份标注"……
每一条反馈都指向具体位置、具体问题,AI 才能精准定位到该改哪块。
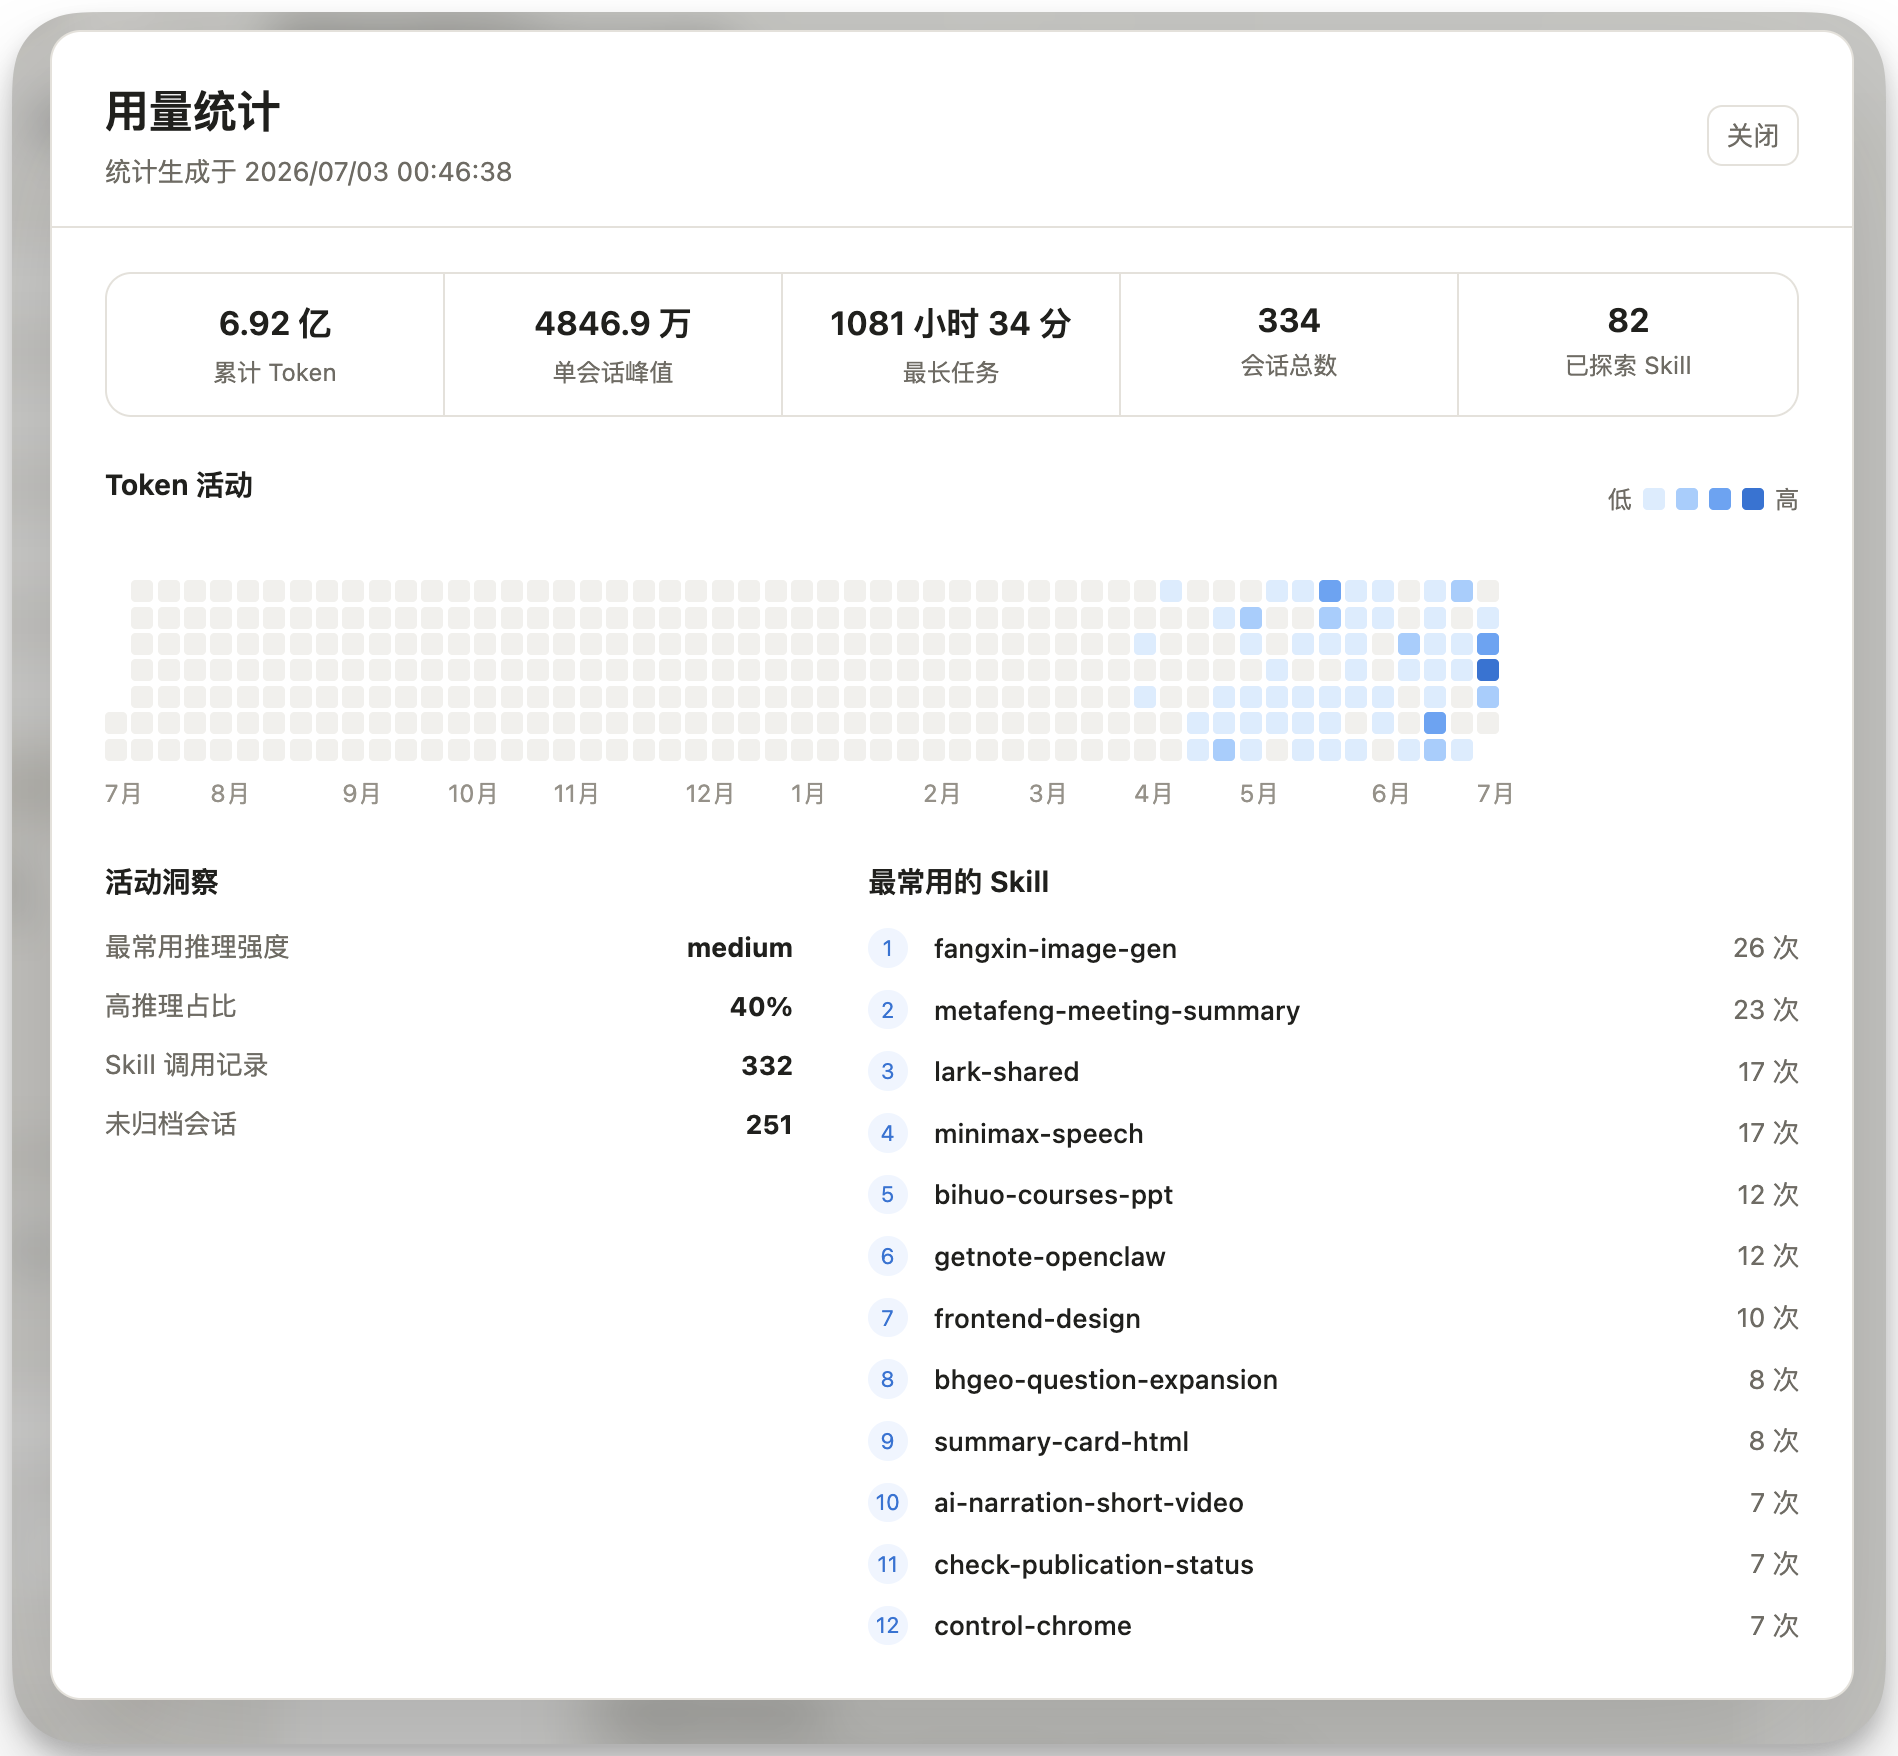
第四步,需求从"能用"逐步长成"适合长期用"——加重要性判断、加筛选器、加用量统计、从 Codex 扩展到 Claude Code……不是一开始就规划好全部功能,而是核心痛点解决之后,围着真实使用继续生长。
AI 在这里做了什么:不只是写代码
- 先读真实本地数据,而不是凭空猜——扫
~/.codex/state_5.sqlite、~/.codex/sessions/**/*.jsonl这些真实文件,先搞清楚数据长什么样,再设计界面 - 把机器字段翻译成人话——原始的
source字段可能只是vscode、cli、unknown,AI 把它拆成"入口来源"(Codex 客户端 / Terminal / Obsidian…)和"场景标签"(飞书 / Skill 工作流 / 普通会话…)两层,用户才看得懂 - 按真实使用路径设计界面——搜索、筛选、点开看对话、复制恢复命令、需要时再看技术细节——高频操作放前面,辅助信息往后收
- 加了一层本地启发式重要性判断——不是上来就上复杂 AI 分类,而是先用长度、关键词、Token 消耗这些透明规则,解决 80% 的判断需求
- 最后做了工程化收尾——建 Git 仓库、写 README、推到 GitHub、正式变成一个可维护的项目
结果:从「Codex session 管理器」长成了「Agent 会话管理器」
现在这个工具同时支持 Codex 和 Claude Code 两套会话管理,能搜索、能筛选、能一键恢复、能看 Token 用量热力图——一个从元峰自己的真实痛点里长出来的产品。
[!tip] 这套方法论,就是四个字:真实、迭代
真实痛点 → 让 AI 理解机制 → 用本地真实数据验证
  → 做最小可用产品 → 按截图和体验持续反馈
  → 把功能放回真实工作流 → 项目化沉淀
很多人用 AI 只停在"帮我写段文案""帮我生成段代码"。但这个案例告诉你:AI 也可以是一个能持续协作的产品工程伙伴——把它当成一个人一样,一步步告诉它哪里不对,它会跟着你迭代到真正能用。
这跟今晚要学的东西有什么关系?
今天你学的"调用别人做好的 Skill"、"培养一个属于自己的 Skill",接下来要学的"生产线",是"把这些 Skill 串起来解决你重复要做的事"——这些都还是在已有能力范围内做组合。
而元峰做会话管理器这件事,是更高一层:发现一个真实痛点,直接用 Codex 从零造一个解决方案。
这条路不需要你今晚就走到底。但今晚"设计你自己的工作流"那套五问框架,底层逻辑跟这个案例是同一套——真实痛点、想清楚要什么、持续反馈迭代。生产线是这条路上的第一步,练熟了,你也能像这样,把自己的痛点做成一个真正的产品。
从装了几个 Skill,到让这位员工自己跑生产线
今天你的这位数字员工,装了好几个新 Skill——上午装的去 AI 味、画图两个,下午又装了做 PPT 的、学会了管笔记的"得到大脑",还亲手为他量身定制了一个完全属于你自己的 Skill。每一个 Skill,他都能独立把那一件事做好。
但真实的业务从来不是"掌握一项技能"就结束了。
你要拍一条短视频,不是写完文案就行——还要想标题、配标签、存档、复盘。你要做个人 IP,不是发几条内容就行——还要先想清楚自己是谁、定位是什么、账号叫什么。
这些环节串起来,就是一套工作流。 元峰自己每天在用的"老板 IP 系统"就是一个真实例子——14 个 Skill 组成一整条内容生产线,从"AI 认识你"到"每天自动产出短视频文案",全部打通。这套系统怎么拆解、怎么照着搭一条属于你自己的生产线,整理成了一份选修补充材料(见文末),感兴趣可以课后自学。
今晚现场,我们先把最基础也最关键的一块打通:让 Codex 真正"记住你"。 这是后面所有工作流、自动化能跑起来的地基——没有这一步,能力装得再多,也只是一次性的。
建起你的第二大脑,让 Codex 真正认识你
上午你用 Codex 搜过资料、跑过插件、调过 Skill,也建了一个项目、写了一份最简单的 AGENTS.md。很好用,对吧?
但停下来想一个问题:Codex 现在到底有多了解你?
答案是:不多。上午那份 AGENTS.md 只写了"这是个课程项目"——Codex 知道今天在干什么,但不知道你是谁、做什么生意、说话什么调调。你每次开新对话,还是要重新交代背景。
这不是 Codex 的 bug,这是所有 AI 的默认状态:它活在一个没有长期记忆的世界里。 所以你每次用 AI,其实都只用了它 10% 的能力。另外 90% 卡在一件事上——你没有给它一个真正的"外挂大脑"。
什么是外挂大脑?就是一个地方,把你和 AI 长期合作时用到的所有东西都存下来:
- 你是谁、做什么、目标客户是谁
- 你的品牌资料、客户背景、历史稿子
- 你的工作规则("开头不要书面语""结尾要有行动号召")
- 每次任务的输出结果——让下一次可以继续,不需要重来
有了这个外挂大脑,Codex 每次打开项目就会先读一遍,知道它在跟谁合作、文件在哪、规则是什么,不需要你重新解释。你从"每次都要从零开始的用户",变成"有积累、有规则、越用越省力"的人。
这个外挂大脑,就是 Obsidian。
先认识一下 Obsidian
Obsidian 是什么?
Obsidian 是一款免费的本地 Markdown 笔记软件。所有笔记都是普通文本文件,存在你自己的电脑上——不是云端,不是别人的服务器,就在你电脑的某个文件夹里。
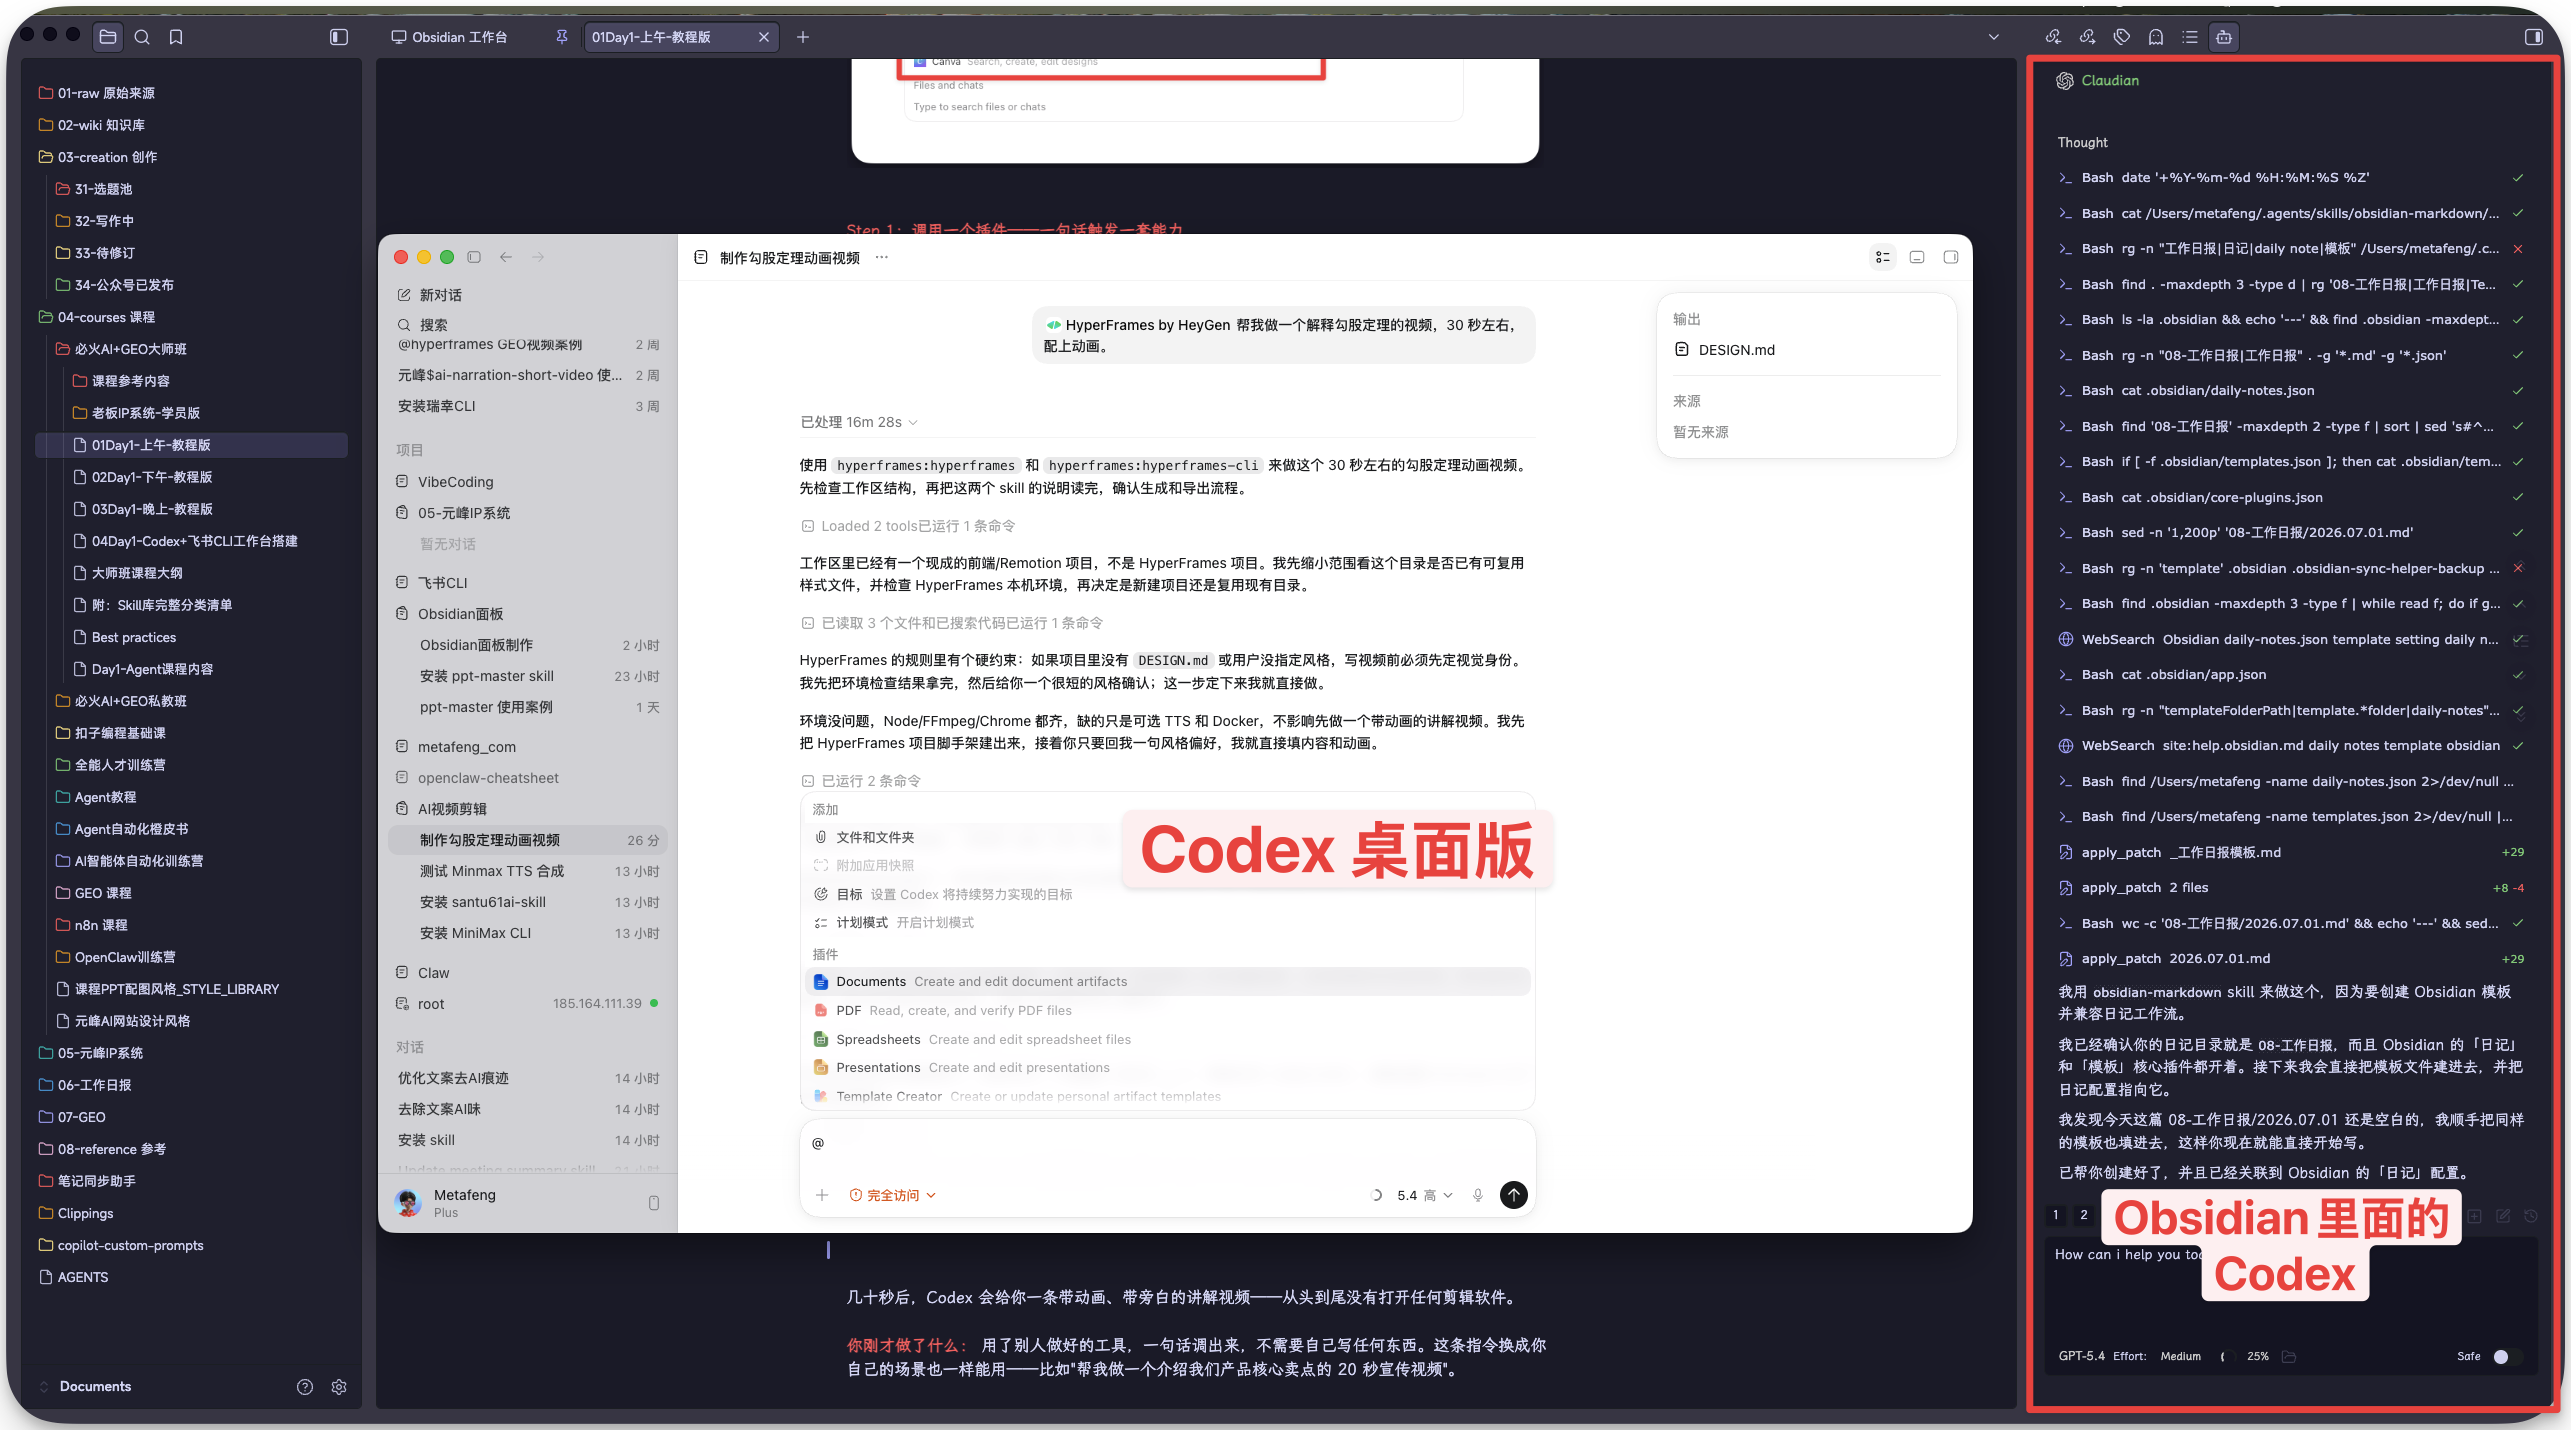
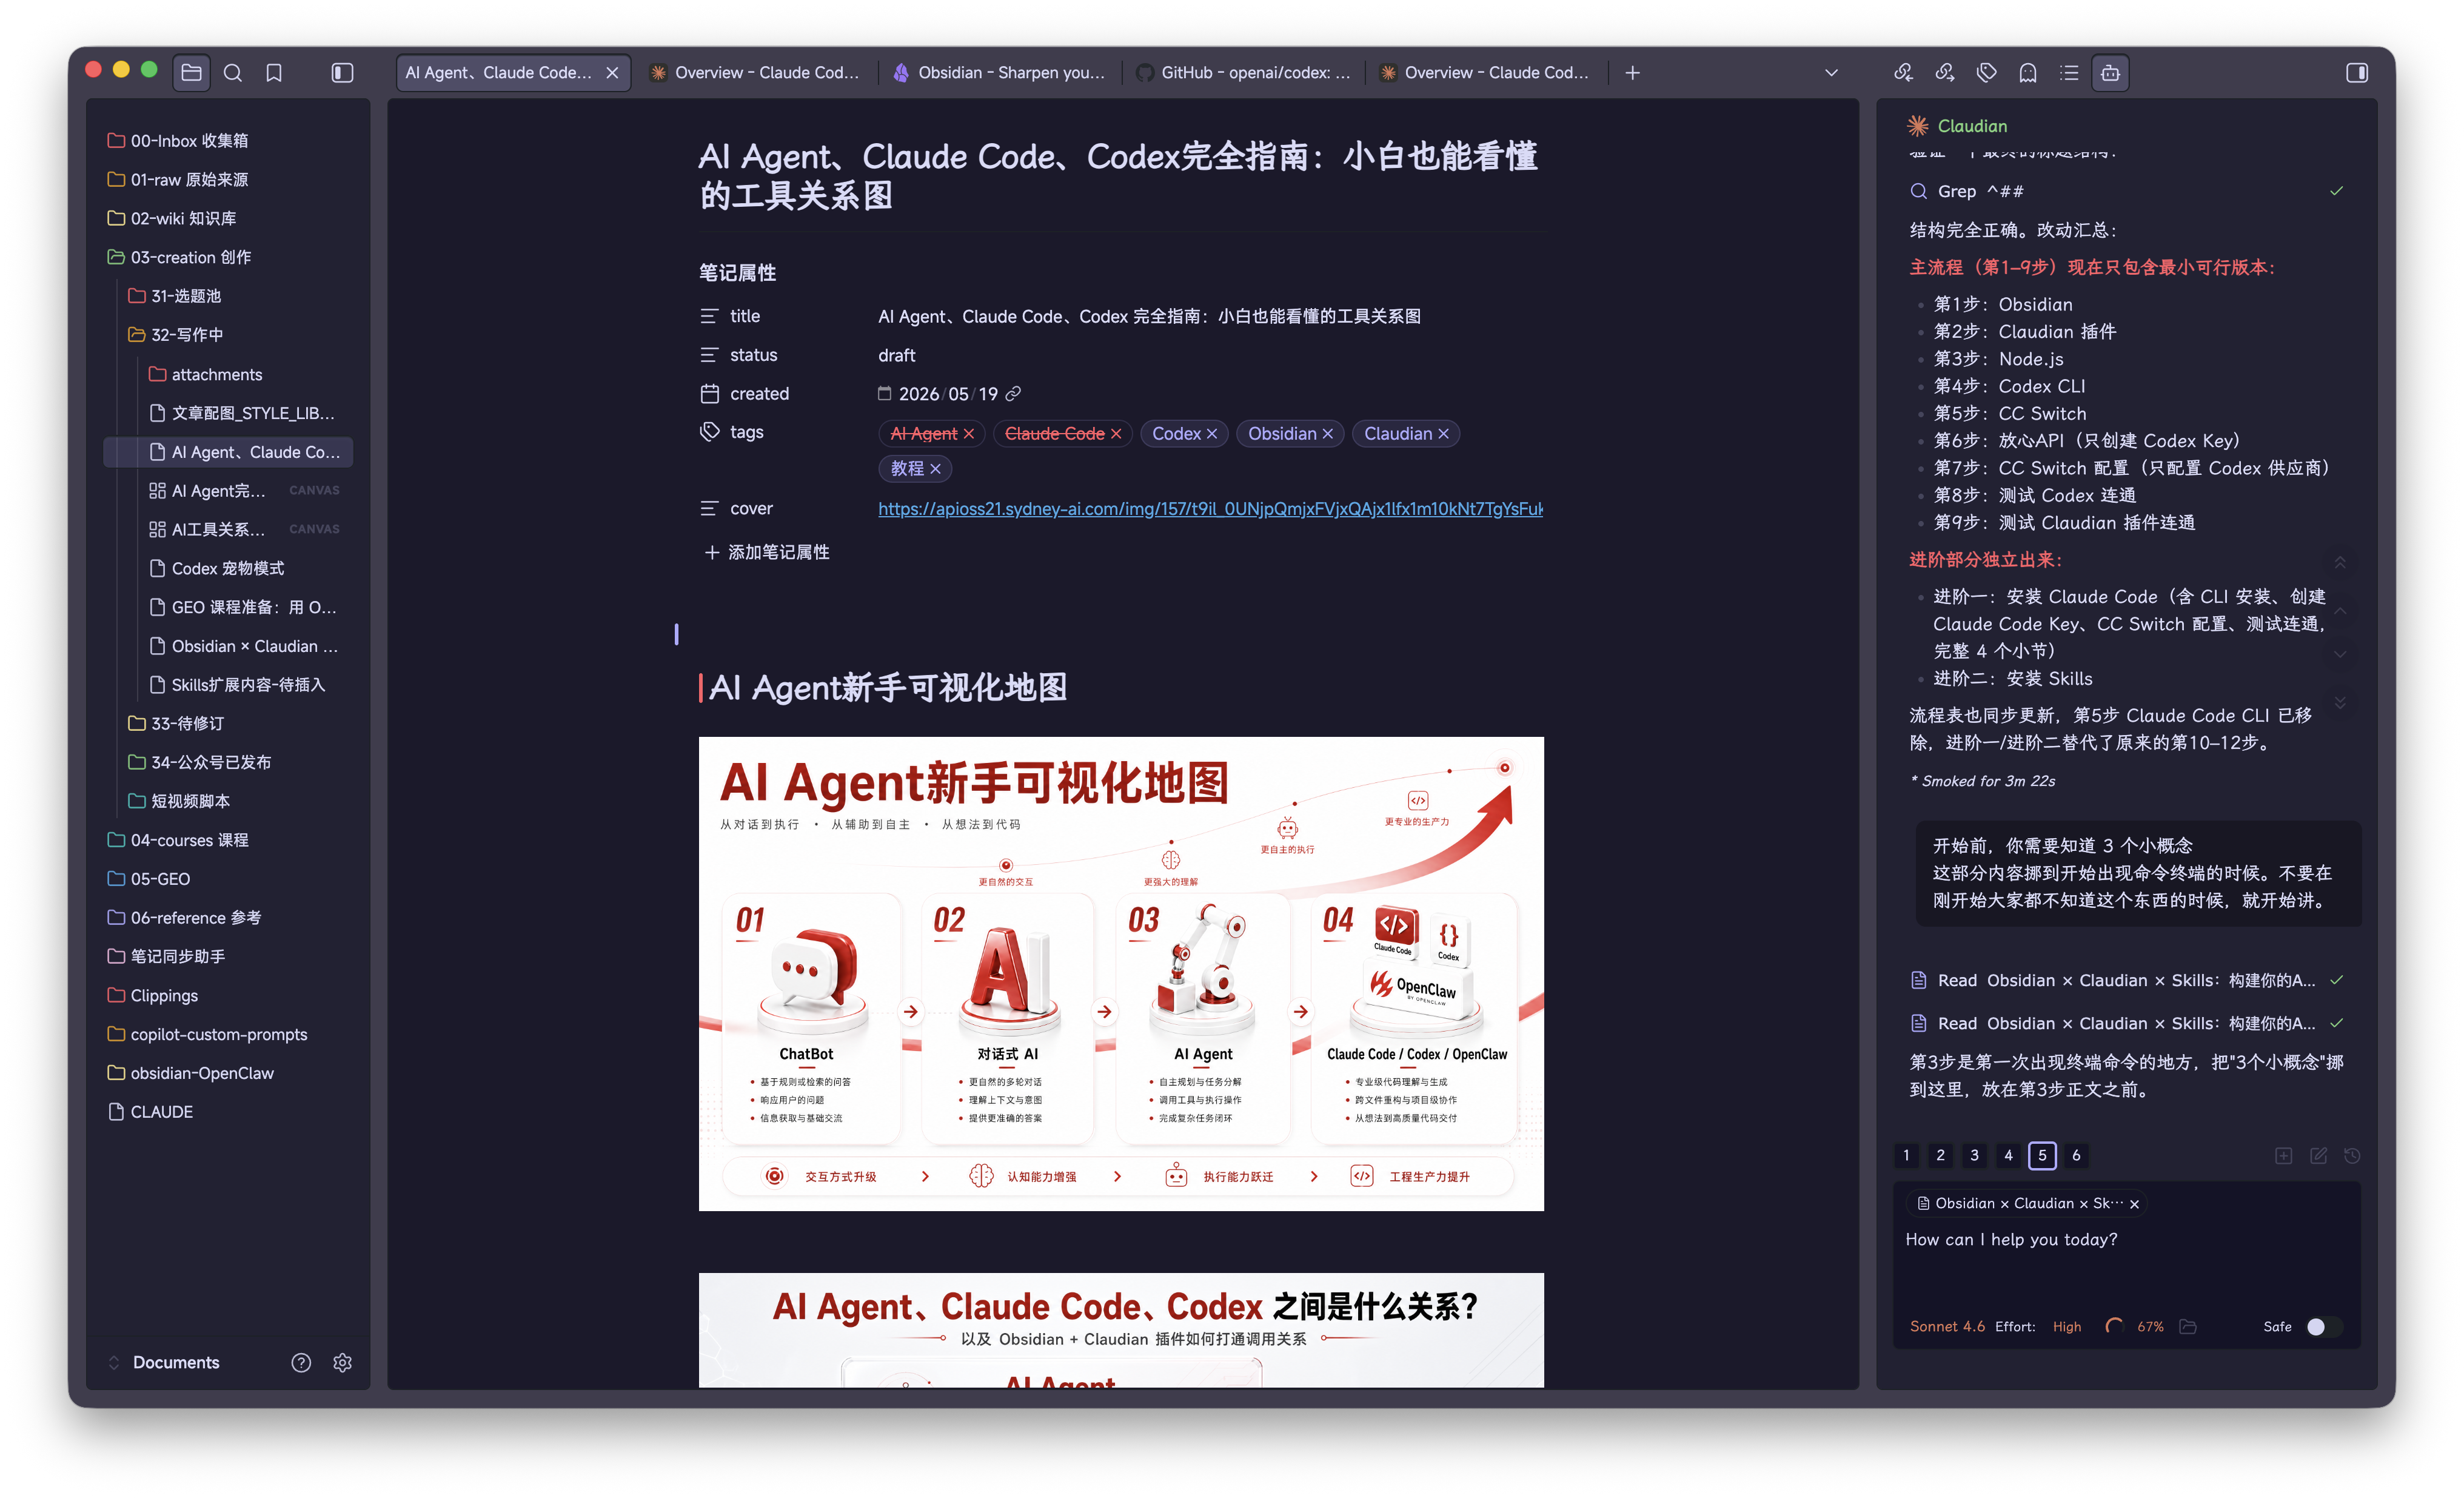
打开 Obsidian,你会看到三栏布局:
| 区域 | 是什么 | 用来干什么 |
|---|---|---|
| 左侧:文件栏 | 你的仓库目录树 | 查看整个知识库结构,点击切换笔记 |
| 中间:内容区 | 当前打开的笔记 | 阅读和编辑笔记内容 |
| 右侧:Claudian 面板 | 内嵌的 AI 聊天窗口 | 向 AI 提问,它能直接读到你正在看的笔记 |
仓库 vs 本地文件夹——搞清楚这个,后面就不迷糊了
学员最常问的一个问题:"Obsidian 的仓库,和我电脑上的文件夹是什么关系?"
[!note] 一句话说清楚
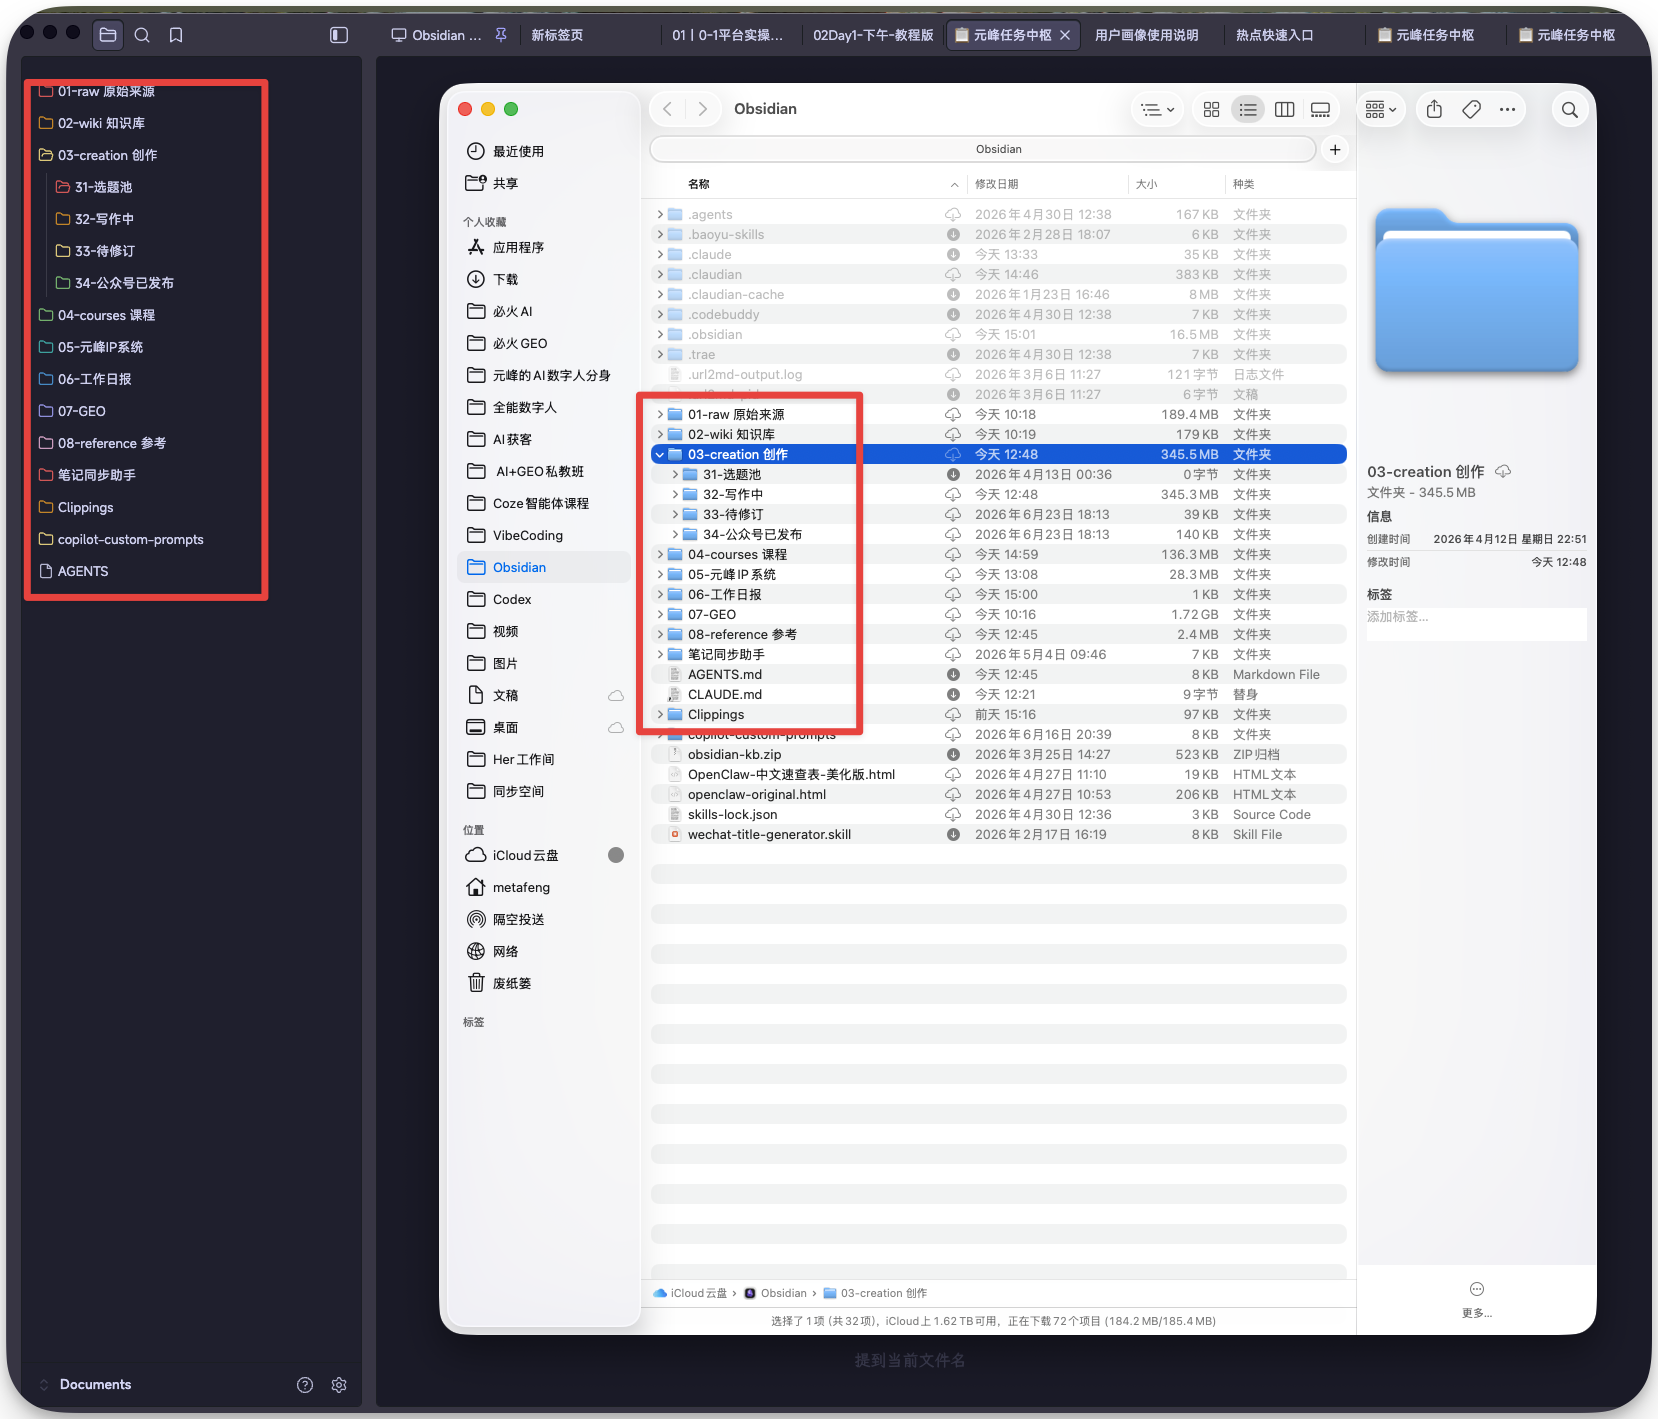
Obsidian 的"仓库"(Vault)就是你电脑上的一个普通文件夹,没有任何魔法。Obsidian 只是这个文件夹的可视化界面,加上了笔记之间互相链接的能力。
具体来说:
- 你在 Obsidian 左侧看到的文件树 = 那个文件夹里的文件列表
- Codex 往这个文件夹里写了一个文件 → Obsidian 左侧立刻出现
- 你在电脑 Finder / 文件管理器里打开这个文件夹 → 和 Obsidian 里看到的完全一样
- 你在 Obsidian 里删掉一个文件 → 电脑上那个文件也消失了
所以你不需要"导出""同步"或者"上传"——Codex 写的文件直接就在 Obsidian 里,点开就能看。
Obsidian 里的 Codex,和我们一直用的是同一个东西
另外,很多同学会问:右侧的 Claudian 和 Codex 客户端,是两个不同的 AI 吗?
不是。它们是同一个 Codex,只是在不同地方用而已。
你上午在 Codex 客户端里用的,是一个通用的 AI 工作台——它什么都能干:上网、写文件、跑任务。而 Obsidian 里,本质上就是把同一个 Codex 接进了 Obsidian 里,让你可以在笔记旁边直接跟它对话。
可以这样理解:Obsidian 是 Codex 在写作和知识管理这个细分场景下的专属工作间。
你把 Codex 请进了这间屋子,它能直接看到这间屋子里所有的资料——你正在写的笔记、左侧的文件夹、历史存下来的内容——不需要你手动复制粘贴,它开口就能用。
所以,同一个 Codex:
- 在客户端里:你让它去外面干活(上网、批量处理、跑任务)
- 在 Obsidian 里:它坐在你的资料堆里陪你写(读笔记、整理、改稿)
这也是为什么 Obsidian 能作为外挂大脑——Codex 进来之后,你所有积累的东西它随时能读到,而不是每次都要你重新喂给它。